Modelli disponibili
Questa pagina serve a due cose: scegliere con cognizione di causa quando esci da Auto, e rispondere a chi ti chiede quali modelli trattano i vostri contenuti, la domanda che arriva puntuale in ogni questionario di sicurezza.
Tutti i modelli del catalogo sono ospitati in UE, come indicato nella scheda di ciascuno dentro il selettore. Fanno eccezione i modelli personalizzati che la vostra area di lavoro ha aggiunto con le proprie chiavi: la loro scheda non riporta l’indicazione, e dove girano dipende da come li avete configurati.
L’elenco
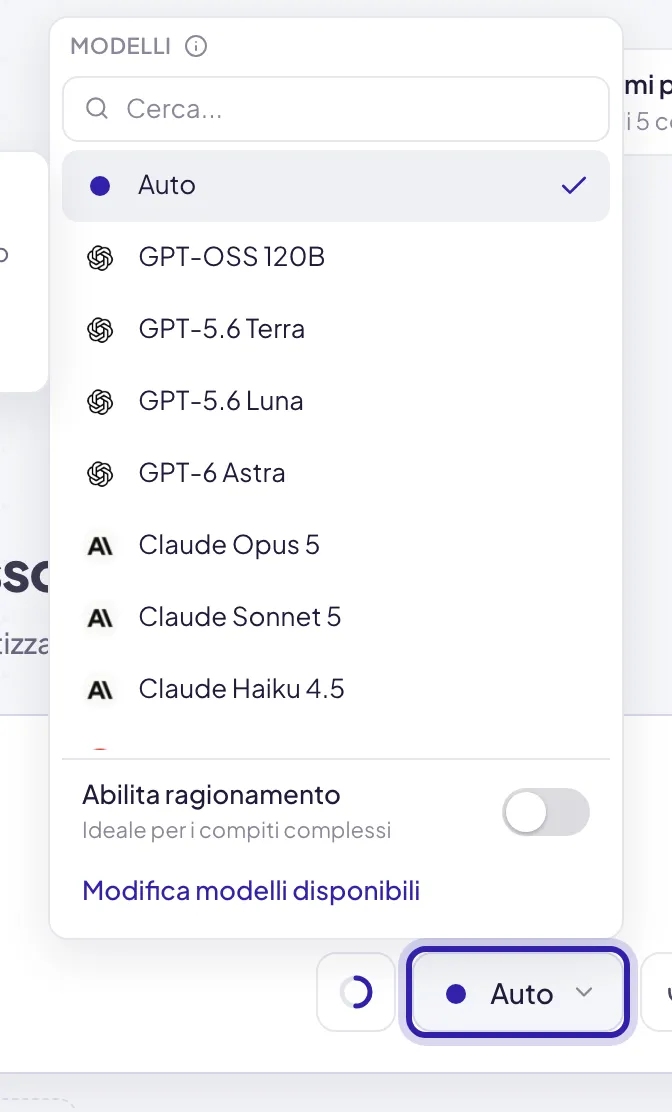
Il consumo dice quanto una risposta pesa sull’utilizzo incluso: basso, medio o alto. È lo stesso dato che vedi nella scheda del modello, passandoci sopra nel selettore.
Non tutti i modelli del catalogo sono accesi. In un’area di lavoro nuova sono attivi Auto, GPT-OSS 120B e i 9 modelli segnati qui sotto; gli altri li accende chi amministra.
Chi amministra l’area di lavoro decide quali di questi compaiono nel tuo selettore, e può riservarne alcuni a certe persone o gruppi. Se un collega ne usa uno che tu non vedi, è questo il motivo. → Modelli disponibili
Cosa sceglie Auto, e con quale criterio
Auto non ragiona sulla conversazione: guarda il singolo messaggio che stai inviando e sceglie fra due corsie.
Va sulla corsia potente quando si verifica anche una sola di queste condizioni:
- il messaggio supera i 600 caratteri;
- il messaggio ha degli allegati;
- nel messaggio è attiva un’integrazione, menzionata con @ o accesa dal menu +.
In tutti gli altri casi va sulla corsia veloce. Le parole che usi non contano: «confronta le due versioni e spiegami cosa cambia», scritto da solo, va sulla corsia veloce come «che differenza c’è?».
Sapere il criterio ti dà una leva. Se una domanda breve merita il modello migliore, sceglilo a mano nel selettore per quel messaggio. Se invece l’ultima risposta ti è sembrata sbrigativa, non è la conversazione ad aver cambiato passo: è quel messaggio che è finito nella corsia veloce.
Le due corsie di Auto sono configurabili da chi amministra l’area di lavoro: i modelli qui sopra sono quelli predefiniti. Se il comportamento non corrisponde, chiedi come sono impostate.
I modelli che lavorano dietro le quinte
Il selettore riguarda solo il modello che scrive la risposta. Alcune funzioni ne usano altri, fissi, che non compaiono da nessuna parte nell’interfaccia. Vale la pena conoscerli: sono la parte che manca quando compili un questionario sui fornitori.
Questi non li scegli e non incidono sul selettore. Cambiare modello nella chat non cambia chi genera un’immagine né chi trascrive la tua voce.
Quando risponde un modello diverso da quello che hai scelto
Succede, ed è previsto. Le cause sono due e conviene distinguerle, perché si risolvono in modo diverso.
L’utilizzo incluso è esaurito. Userbot non si ferma: passa a GPT-OSS 120B e continua a rispondere. Te lo dice sopra il campo di scrittura e nel selettore, dove compare «Crediti esauriti: puoi usare solo GPT-OSS.» e tutti gli altri modelli, Auto compreso, hanno un lucchetto. Si risolve solo se chi amministra alza i limiti o ricarica il credito. → Contesto e conversazioni lunghe
Il modello scelto non risponde. Un guasto momentaneo del fornitore. In questo caso la richiesta viene rifatta subito con GPT-OSS 120B, senza avvisi e senza che tu debba fare nulla. Il segnale è indiretto: sotto la risposta il modello indicato non è quello che avevi selezionato. Se il risultato non ti convince, usa Rigenera: al tentativo successivo il modello primario spesso è già tornato disponibile.
Con un allegato nel messaggio non esiste ripiego: la riserva viene forzata uguale al modello principale, perché un modello diverso potrebbe non saper leggere quel file. La conseguenza è che una chat con allegato fallisce dove la stessa chat senza allegato avrebbe risposto in modo degradato. Se un messaggio con file allegato non parte e senza file parte, hai trovato il motivo: riprova fra qualche minuto o cambia modello a mano.
Come si sceglie, in pratica
Non serve una regola per ogni modello. Ne bastano 3.
- Resta su Auto finché non hai un motivo preciso per cambiare. È l’impostazione che sbaglia meno, perché decide messaggio per messaggio.
- Scegli un consumo basso quando devi fare la stessa cosa 50 volte: correggere, tradurre, riformulare. Un modello leggero fa lo stesso lavoro consumando una frazione.
- Scegli un consumo alto quando un errore intermedio rovina tutto il resto: calcoli concatenati, confronti riga per riga, decisioni delicate.